24 R Modulo 13 - Gráficos de ordenação e DCA
24.1 Organização básica
dev.off() #apaga os graficos, se houver algum
rm(list=ls(all=TRUE)) #limpa a memória
cat("\014") #limpa o console
Instalando os pacotes necessários para esse módulo
install.packages("vegan3d")
install.packages("geometry")
install.packages("magick")
Agora vamos definir o diretório de trabalho. Esse código é usado para obter e definir o diretório de trabalho atual no R. O comando getwd() retorna o caminho do diretório onde o R está lendo e salvando arquivos. O comando setwd() muda esse diretório de trabalho para o caminho especificado entre aspas. No seu caso, você deve ajustar o caminho para o seu próprio diretório de trabalho. Lembre de usar a barra “/” entre os diretórios. E não a contra-barra “\”.
Definindo o diretório de trabalho e installando os pacotes necessários:
24.1.1 Sobre os dados do PPBio
A planilha ppbio contém os dados de abundância de espécies em diferentes unidades amostrais (UA’s). A base teórica dos dados do PPBio para o presente estudo pode ser vista em Base Teórica. Leia antes de prosseguir.
24.1.2 A planilha PPBio Grupos
Para esse módulo também usaremos a planilha ppbio06-grupos. Esta é uma tabela de agrupamentos, guardados no arquivo ppbio06-grupos.xlsx, que traz os agrupamentos das UA’s definidos a priori no delineamento amostral do PPBio. Essa tabela contem as ~26 localidades (UAs) em períodos diferentes (linhas) x ~5 tipos de grupos aos quais cada UA foi atribuida (colunas) (dados publicados por (RN2491?)). As bases teóricas dos dados do PPBio para o presente estudo pode ser vista em Base Teórica. Leia antes de prosseguir.
24.1.3 Importando as planilhas
Note que o símbolo # em programação R significa que o texto que vem depois dele é um comentário e não será executado pelo programa. Isso é útil para explicar o código ou deixar anotações.
- Ajuste a primeira linha do código abaixo para refletir “C:/Seu/Diretório/De/Trabalho/Planilha.xlsx”.
- Ajuste o parâmetro sheet = "" para refletir a aba correta do arquivo .xlsx a ser importado.
Alternativamente você pode ir na barra de tarefas e escolhes as opções:
SESSION -> SET WORKING DIRECTORY -> CHOOSE DIRECTORY
library(openxlsx)
ppbio <- read.xlsx("D:/Elvio/OneDrive/Disciplinas/_EcoNumerica/5.Matrizes/ppbio06p-peixes.xlsx",
                   rowNames = T,
                   colNames = T,
                   sheet = "Sheet1")
t_grps <- read.xlsx("D:/Elvio/OneDrive/Disciplinas/_EcoNumerica/5.Matrizes/ppbio06-grupos.xlsx",
                   rowNames = T,
                   colNames = T,
                   sheet = "peixesp")
m_hab <- read.xlsx("D:/Elvio/OneDrive/Disciplinas/_EcoNumerica/5.Matrizes/ppbio06p-amb.xlsx",
                   rowNames = T,
                   colNames = T,
                   sheet = "ano1")
ppbio[1:5,1:5] #[1:5,1:5] mostra apenas as linhas e colunas de 1 a 5.
t_grps
## ap-davis as-bimac as-fasci ch-bimac ci-ocela
## S-R-CT1 0 194 55 0 0
## S-R-CP1 0 19 0 0 0
## S-A-TA1 0 23 1 13 0
## S-R-CT2 0 142 3 3 0
## S-R-CP2 0 5 1 0 40
## area ambiente UA coleta
## S-R-CT1 Serido rio CT 1
## S-R-CP1 Serido rio CP 1
## S-A-TA1 Serido acude TA 1
## S-R-CT2 Serido rio CT 2
## S-R-CP2 Serido rio CP 2
## S-A-TA2 Serido acude TA 2
## S-R-CT3 Serido rio CT 3
## S-R-CP3 Serido rio CP 3
## S-A-TA3 Serido acude TA 3
## S-R-CT4 Serido rio CT 4
## S-R-CP4 Serido rio CP 4
## S-A-TA4 Serido acude TA 4
## B-A-MU1 Buique acude MU 1
## B-A-GU1 Buique acude GU 1
## B-R-PC2 Buique rio PC 2
## B-A-MU2 Buique acude MU 2
## B-A-GU2 Buique acude GU 2
## B-R-PC3 Buique rio PC 3
## B-A-MU3 Buique acude MU 3
## B-A-GU3 Buique acude GU 3
## B-R-PC4 Buique rio PC 4
## B-A-MU4 Buique acude MU 4
## B-A-GU4 Buique acude GU 424.2 REINÍCIO 1
m_bruta <- (ppbio) # <1>- Aqui usaremos as matrizes relativizadas/transformadas/particionadas, etc
Podemos exibir a planilha depois de ter sido importada para o ambiente R/RStudio usando as funções View(), print() ou head(). Note que essas funções são case-sensitive. A função ignore.case() é uma função do pacote stringr que modifica um padrão para que ele não considere o caso das letras nas correspondências. Por exemplo, se você quiser encontrar todas as ocorrências da letra “a” em um vetor de caracteres, independente de ser “A” ou “a”, você pode usar essa função.
24.3 REINÍCIO 2
m_trab <- (m_bruta) # <1>- Aqui usaremos as matrizes relativizadas/transformadas/particionadas, etc
24.4 DCA
https://www.davidzeleny.net/anadat-r/doku.php/en:ordiagrams_examples
library (vegan)
#veg.data <- read.delim ('https://raw.githubusercontent.com/zdealveindy/anadat-r/master/data/vltava-spe.txt', row.names = 1)
#env.data <- read.delim ('https://raw.githubusercontent.com/zdealveindy/anadat-r/master/data/vltava-env.txt')
com.data <- m_trab
env.data <- t_grps
env.data
#env.data <- within(env.data, ambiente <- factor(ambiente, labels = c(1,2)))
#lvs <- factor(env.data$area, labels = c(2,1))
grp <- env.data$area
env.data$lvs <- factor(env.data$area, labels = c(2,1)) #adiciona uma coluna chamada levels
env.data$lvs <- as.numeric(as.character(env.data$lvs)) #lvs como numeros
lvs <- env.data$lvs

DCA <- decorana(com.data)
DCA
#summary(DCA) não funciona mais
scores(DCA)
weights(DCA)
plot(DCA, choices = c(1,2), display = "sites", type = "text")
points(DCA)
## area ambiente UA coleta
## S-R-CT1 Serido rio CT 1
## S-R-CP1 Serido rio CP 1
## S-A-TA1 Serido acude TA 1
## S-R-CT2 Serido rio CT 2
## S-R-CP2 Serido rio CP 2
## S-A-TA2 Serido acude TA 2
## S-R-CT3 Serido rio CT 3
## S-R-CP3 Serido rio CP 3
## S-A-TA3 Serido acude TA 3
## S-R-CT4 Serido rio CT 4
## S-R-CP4 Serido rio CP 4
## S-A-TA4 Serido acude TA 4
## B-A-MU1 Buique acude MU 1
## B-A-GU1 Buique acude GU 1
## B-R-PC2 Buique rio PC 2
## B-A-MU2 Buique acude MU 2
## B-A-GU2 Buique acude GU 2
## B-R-PC3 Buique rio PC 3
## B-A-MU3 Buique acude MU 3
## B-A-GU3 Buique acude GU 3
## B-R-PC4 Buique rio PC 4
## B-A-MU4 Buique acude MU 4
## B-A-GU4 Buique acude GU 4
##
## Call:
## decorana(veg = com.data)
##
## Detrended correspondence analysis with 26 segments.
## Rescaling of axes with 4 iterations.
## Total inertia (scaled Chi-square): 3.8345
##
## DCA1 DCA2 DCA3 DCA4
## Eigenvalues 0.6772 0.3542 0.3524 0.22035
## Additive Eigenvalues 0.6772 0.3520 0.3686 0.21920
## Decorana values 0.7171 0.3430 0.1673 0.03794
## Axis lengths 4.1449 3.2131 2.7721 1.76694
##
## DCA1 DCA2 DCA3 DCA4
## S-R-CT1 -0.07216570 0.427832648 1.1807335788 -0.49669462
## S-R-CP1 -0.13681087 -0.089812477 0.6019081418 0.50348078
## S-A-TA1 -1.32309112 0.239877504 0.4913614806 0.32273329
## S-R-CT2 0.28632577 -0.610759022 0.1301029364 0.19521337
## S-R-CP2 0.14464202 -1.900141091 -0.5073054265 0.78998471
## S-A-TA2 -2.14973260 -0.087604258 -0.0599233693 0.16712788
## S-R-CT3 0.44782328 -0.731615965 0.0006179036 -0.35122057
## S-R-CP3 -0.06338219 -1.420951274 -0.3064505048 1.16042906
## S-A-TA3 -1.76443604 0.006795231 0.2285711522 0.27382310
## S-R-CT4 1.28624339 0.040435121 -0.2199325317 -0.60651503
## S-R-CP4 0.36341021 -1.562958336 -0.3315141692 -0.13615590
## S-A-TA4 -1.69376866 0.088876886 0.3038423823 0.26594763
## B-A-MU1 -0.01583376 0.935907783 -1.3916276584 -0.46883578
## B-A-GU1 1.23543649 0.241895347 -0.4334781285 -0.02174684
## B-R-PC2 0.41491186 1.312988935 0.3480814060 0.32869812
## B-A-MU2 -0.68988526 0.438438104 -0.2582691339 -0.02430791
## B-A-GU2 1.94507898 0.050928374 -0.4917044451 0.16268004
## B-R-PC3 0.56893463 0.996155146 0.8329764370 0.63486724
## B-A-MU3 -0.84064152 0.284921378 0.0952716174 0.09123688
## B-A-GU3 1.97350519 -0.031507454 -0.2198106772 0.09538355
## B-R-PC4 1.10407898 0.729370515 1.3804736421 1.06400812
## B-A-MU4 -0.39399608 0.205615954 -0.7979188549 -0.27082312
## B-A-GU4 1.99521663 -0.056303605 -0.2147470718 0.17517539
## [1] 545 55 42 717 108 228 1144 68 501 436 104 684 208 25 185
## [16] 186 161 371 762 535 156 1174 342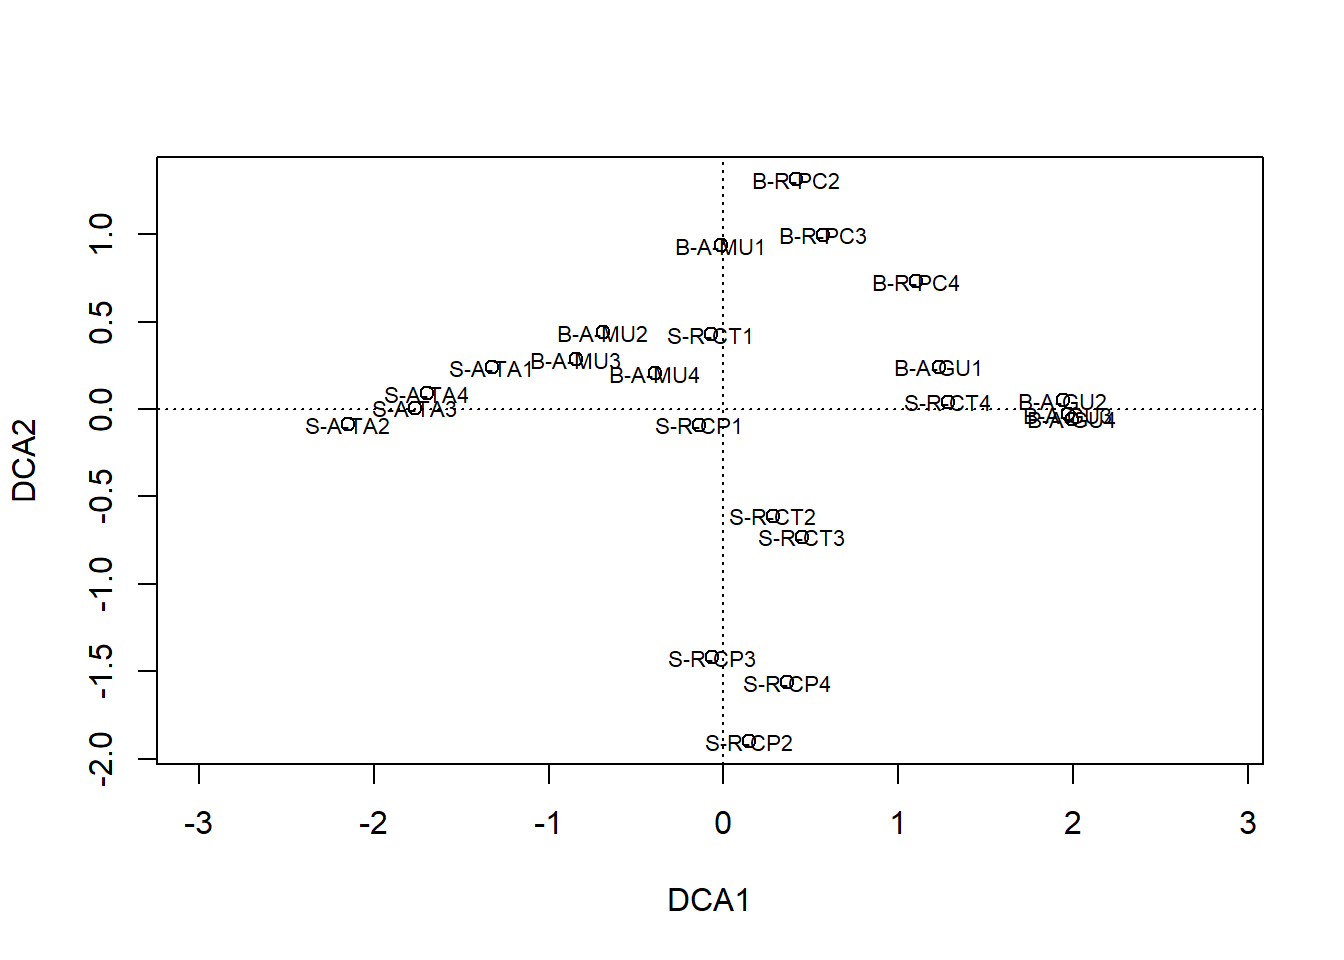
A DCA é uma técnica de ordenação usada em ecologia para entender padrões em dados de abundância de espécies ou composição de comunidades. É uma forma avançada de análise de correspondência que corrige certos artefatos para proporcionar uma representação mais precisa das relações ecológicas.
Resultados da DCA Informações Gerais:
Call: Mostra a função que foi chamada e os dados usados (decorana(com.data)). Detrended correspondence analysis with 26 segments: A análise foi feita com 26 segmentos. Esse detrending ajuda a remover curvas artificiais dos dados. Rescaling of axes with 4 iterations: Os eixos foram reescalados em 4 iterações, o que ajuda a uniformizar a variância ao longo dos eixos. Total inertia (scaled Chi-square): 3.8345: A inércia total representa a variabilidade total nos dados. É uma medida da variação total explicada pelos dados. Eigenvalues e Outros Valores:
Eigenvalues: São valores que indicam a quantidade de variação explicada por cada eixo da DCA. Quanto maior o eigenvalue, mais variação esse eixo explica. DCA1: 0.6772 (primeiro eixo) DCA2: 0.3542 (segundo eixo) DCA3: 0.3524 (terceiro eixo) DCA4: 0.22035 (quarto eixo) Additive Eigenvalues: Esses valores são usados para ajustar os eigenvalues principais. São ligeiramente diferentes dos eigenvalues, refletindo a soma acumulada de variações explicadas. DCA1: 0.6772 DCA2: 0.3520 DCA3: 0.3686 DCA4: 0.21920 Decorana values: Estes valores representam a variância explicada depois do detrending e do reescalamento. DCA1: 0.7171 DCA2: 0.3430 DCA3: 0.1673 DCA4: 0.03794 Axis lengths: Comprimento dos eixos. Indicam a extensão dos dados ao longo de cada eixo. DCA1: 4.1449 DCA2: 3.2131 DCA3: 2.7721 DCA4: 1.76694 Resumo da Interpretação Eixos (DCA1, DCA2, etc.): Representam diferentes dimensões dos dados. O primeiro eixo (DCA1) explica a maior parte da variação, seguido pelo segundo eixo (DCA2), e assim por diante. Eigenvalues: Valores que indicam a quantidade de variação explicada por cada eixo. Eixos com valores maiores são mais importantes para entender a variação nos dados. Axis lengths: Indicam a amplitude dos dados ao longo de cada eixo. Eixos mais longos sugerem maior variabilidade ao longo daquela dimensão. Portanto, a análise de correspondência detrended (DCA) foi usada para entender a variação nos dados de abundância de espécies. Os resultados mostram quantas dimensões (eixos) foram analisadas, quanta variação cada eixo explica (eigenvalues) e a extensão da variabilidade dos dados ao longo de cada eixo (axis lengths).
## Warning in plot.xy(xy.coords(x, y), type = type, ...): "optimize" não é um
## parâmetro gráfico
ordiplot(DCA, display = 'species', type = 't')
ordiplot(DCA, display = 'sp', type = 'n')
orditorp(DCA, display = 'sp')
ordiplot(DCA, display = 'sp', type = 'n')
ordilabel(DCA, display = 'sp')
par(mfrow=c(1,1))

ordiplot(DCA, display = 'si', type = 'n')
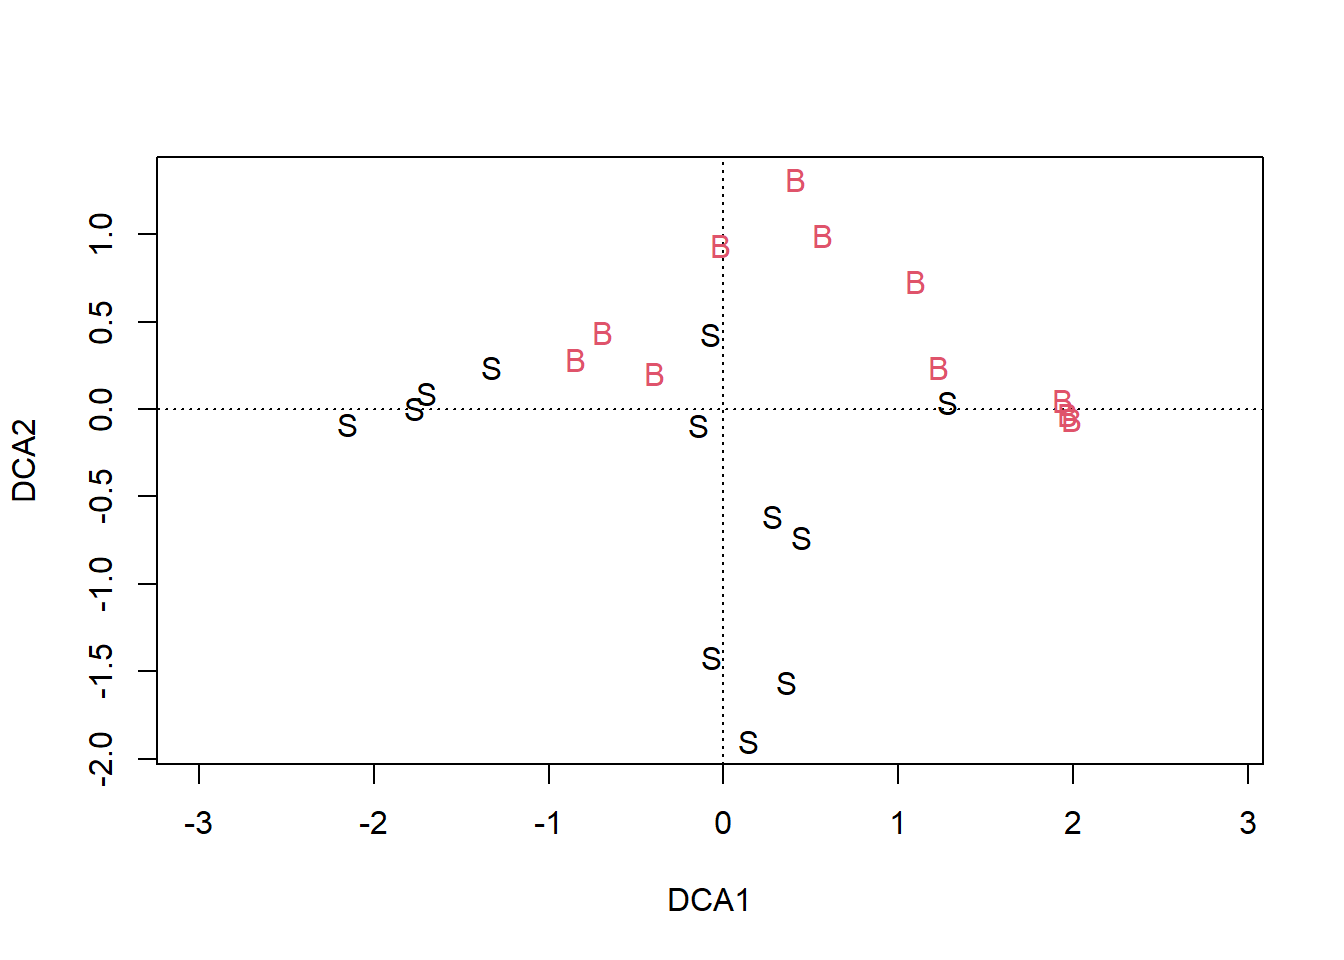
points(DCA, col = lvs, pch = grp)

ordiplot(DCA, display = 'si', type = 'n')
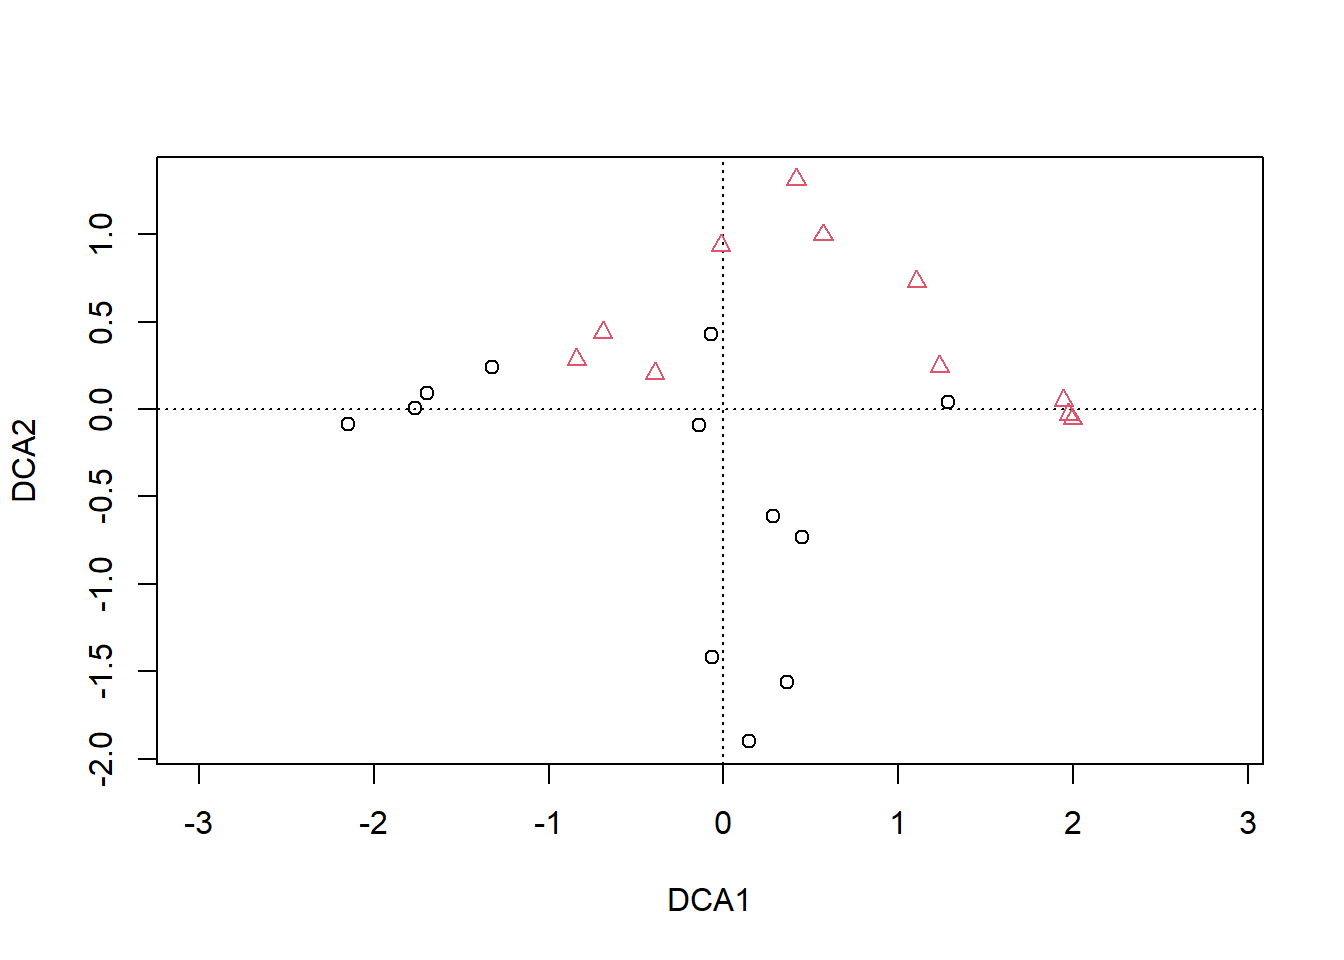
points(DCA, col = lvs, pch = lvs)

ordiplot(DCA, display = 'si', type = 'n')
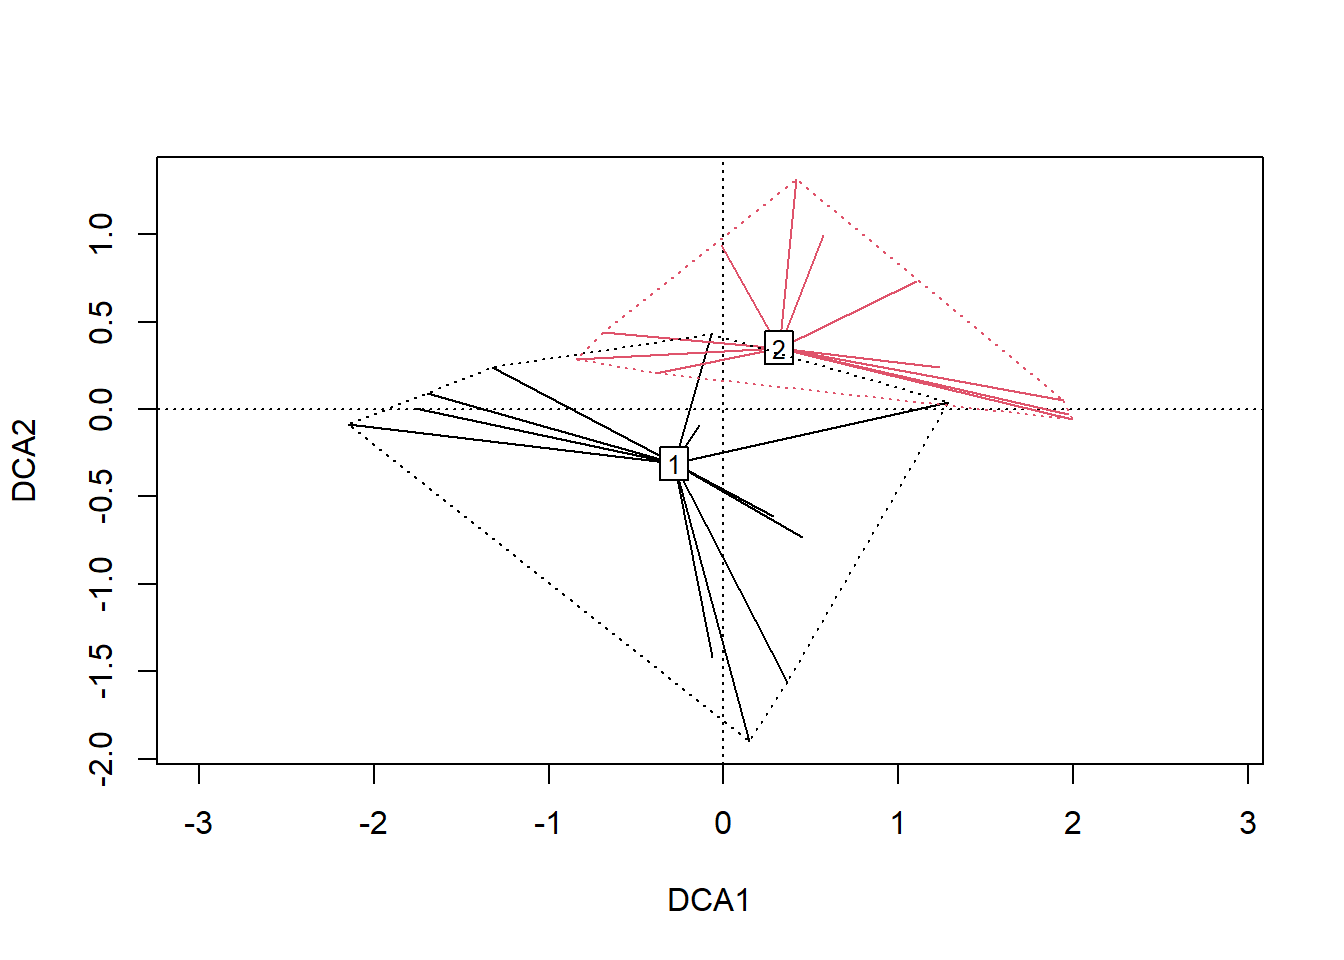
for (i in seq (1, 2)) ordispider(DCA, groups = lvs, show.groups = i, col = i, label = T)
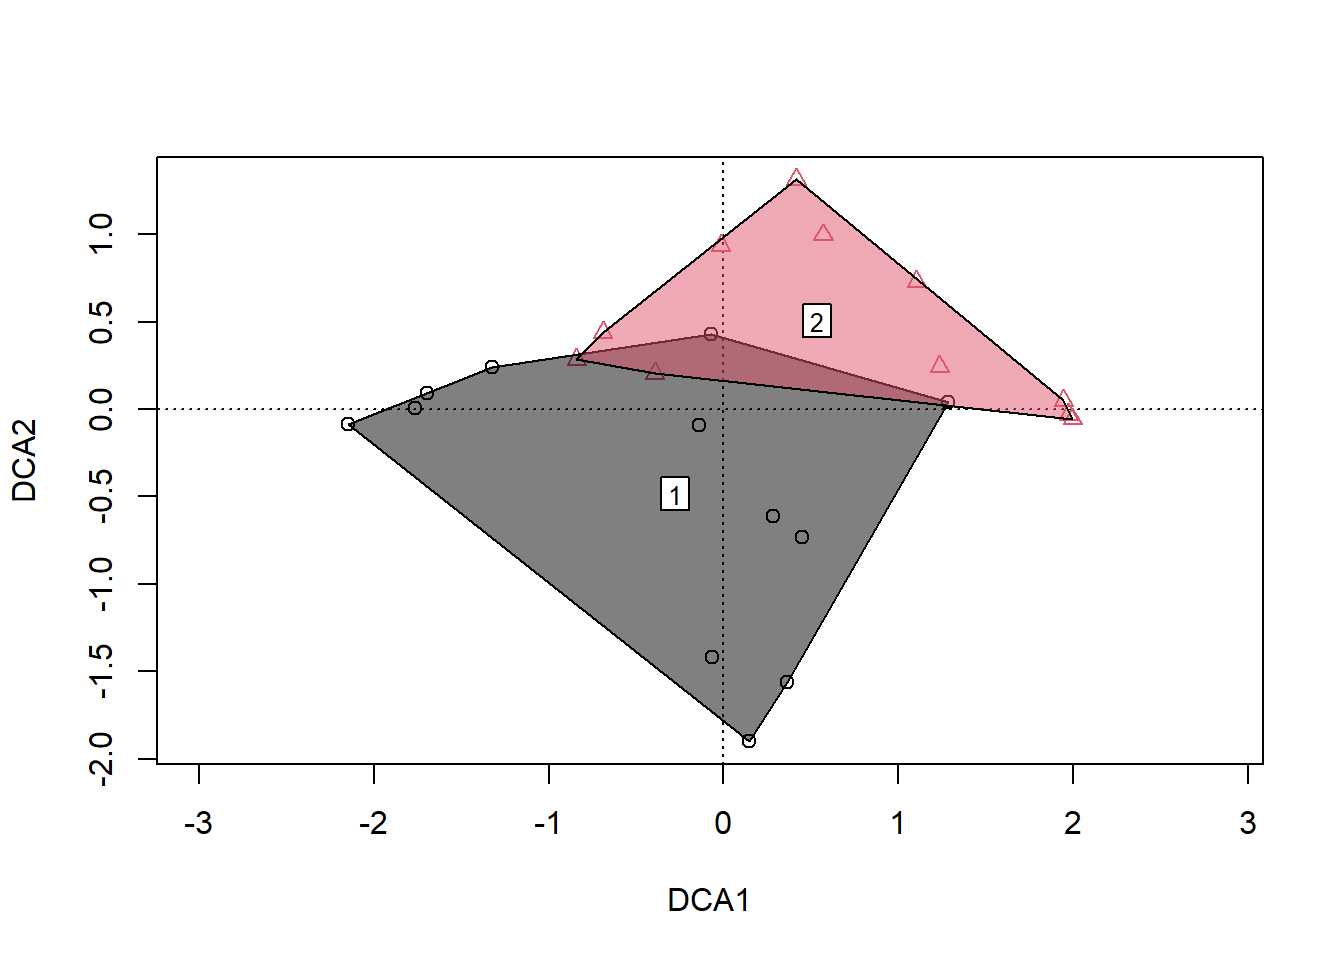
for (i in seq (1, 2)) ordihull(DCA, groups = lvs, show.groups = i, col = i, lty = 'dotted')

ordiplot(DCA, display = 'si', type = 'n')
points(DCA, col = lvs, pch = lvs)
for (i in unique (lvs)) ordihull (DCA, groups = lvs, show.group = i, col = i, draw = 'polygon', label = T)

source('http://www.davidzeleny.net/anadat-r/doku.php/en:customized_functions:ordicenter?do=export_code&codeblock=0')
ordiplot(DCA, display = 'si', type = 'n')
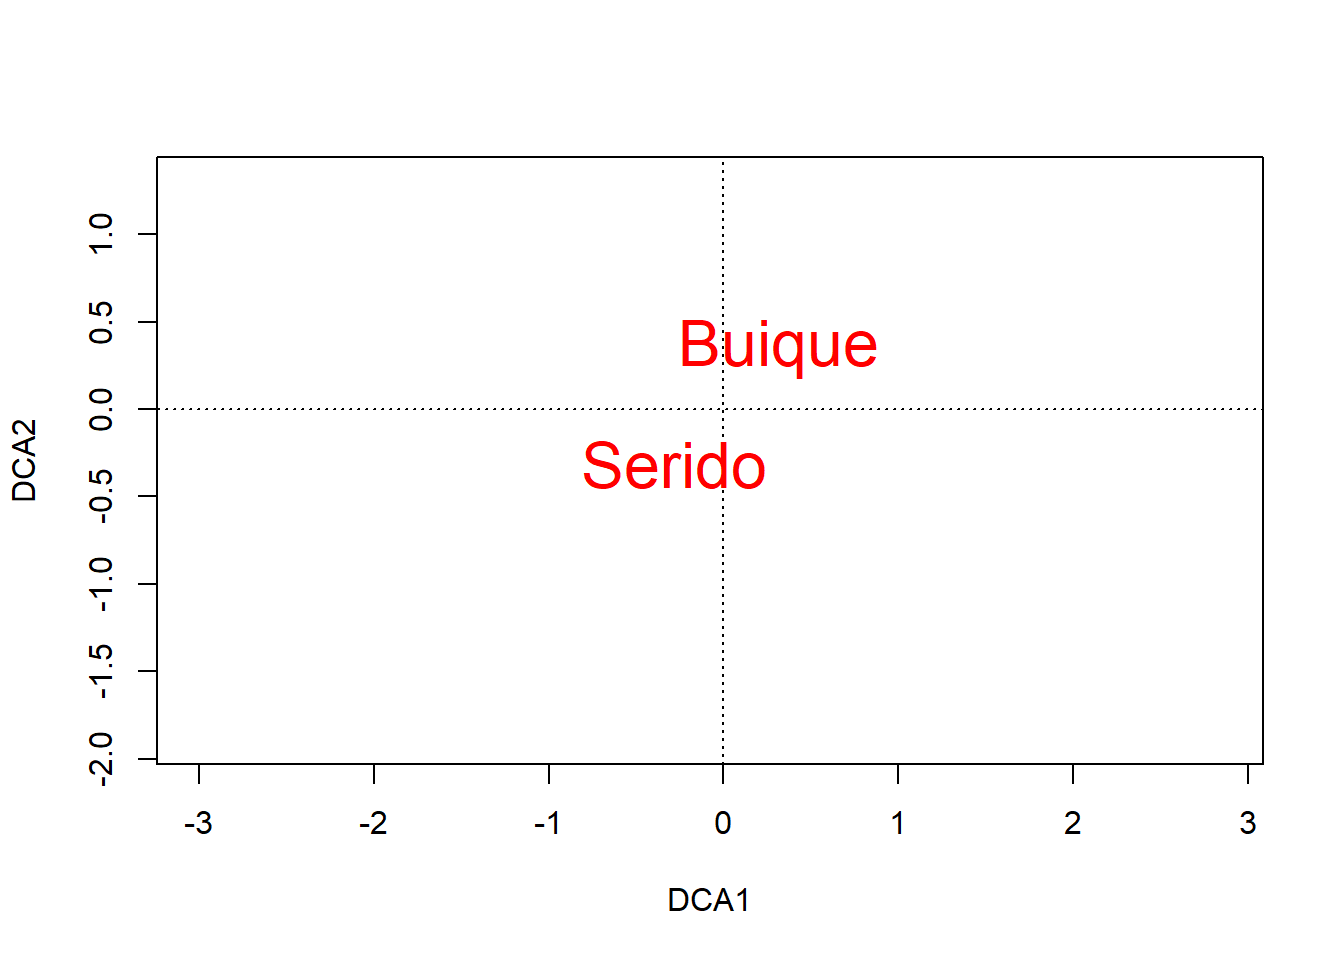
ordicenter(DCA, groups = grp, col = 'red', cex = 2)

ordiplot(DCA, display = 'si', type = 'n')
scaling.parameter <- as.vector(table(lvs))/max(as.vector(table(lvs)))
for (i in 1:length (unique (lvs)))
  ordicenter (DCA, groups = lvs, show.groups = i, col = i, cex = 4*scaling.parameter[i])

colnames(m_hab)
ordiplot(DCA, display = 'si', type = 'n')
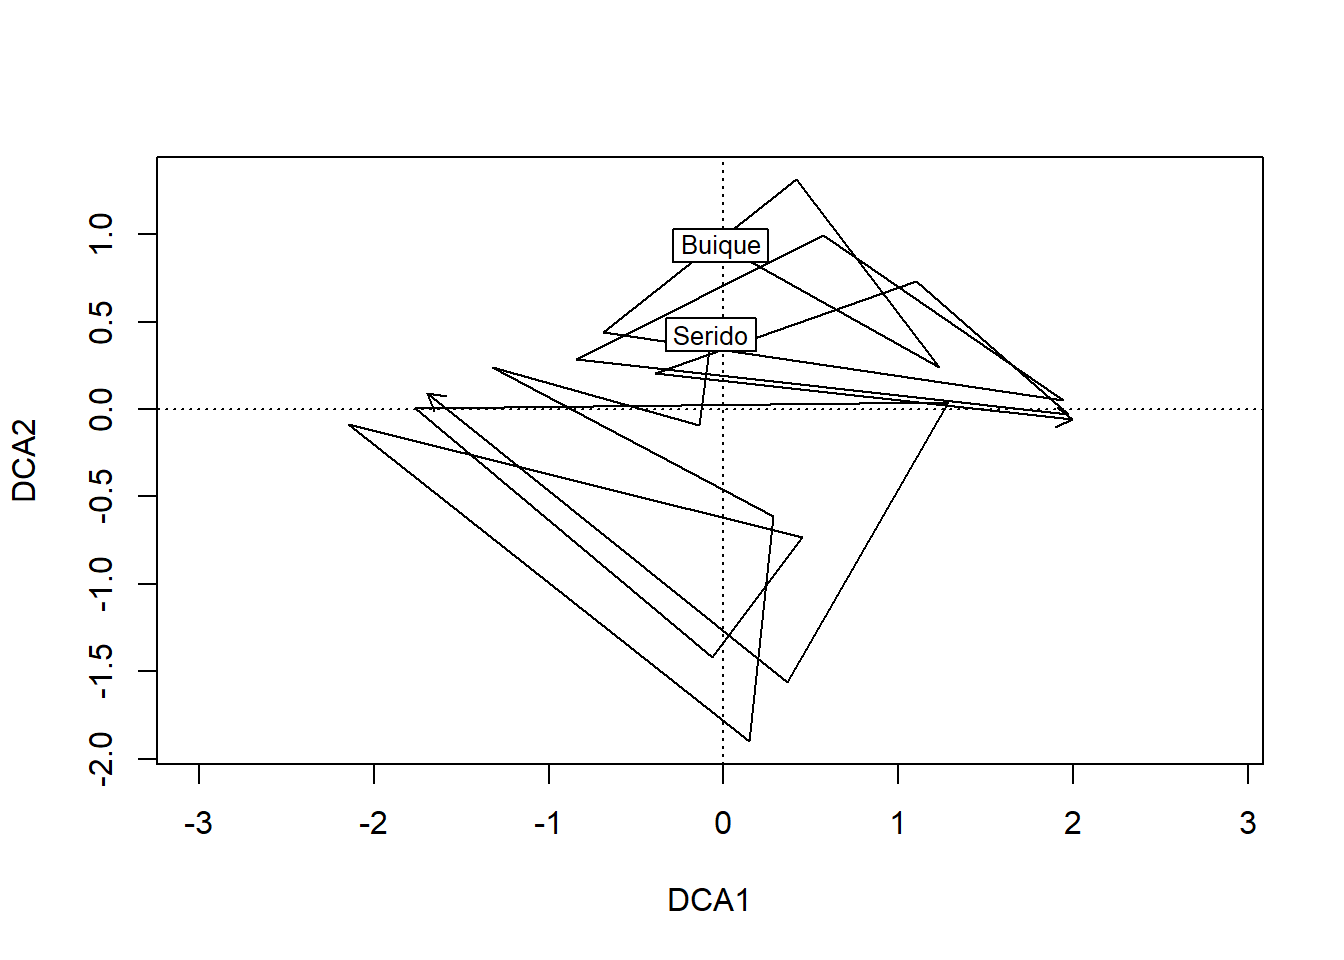
ordiarrows(DCA, groups = env.data$area, order.by = grp, startmark = 1, label = TRUE, length = .1) #integers
## [1] "h.macroph" "h.grass" "h.subveg" "h.overhveg" "h.litter"
## [6] "h.filalgae" "h.attalgae" "h.roots" "h.lrgdeb" "h.smldeb"
## [11] "s.mud" "s.sand" "s.smlgrav" "s.lrggrav" "s.cobbles"
## [16] "s.rocks" "s.bedrock" "m.elev" "m.river" "m.stream"
## [21] "m.distsource" "m.distmouth" "m.maxslope" "m.maxdepth" "m.habdepth"
## [26] "m.width" "a.veloc" "a.temp" "a.do" "a.transp"
24.4.1 Fazendo gráficos em 3D
Ao executar a função ´ordirgl()´ procure pelo widget criado usando o pacote rgl e abra-o em uma segunda tela.
##
## Anexando pacote: 'vegan3d'
## Os seguintes objetos são mascarados por 'package:vegan':
##
## orditkplot, panel.ordi3d, prepanel.ordi3d
library(rgl)
ordirgl(DCA)
orglspider(DCA, groups = grp)
source('http://www.davidzeleny.net/anadat-r/doku.php/en:customized_functions:orglhull?do=export_code&codeblock=1')
#orglhull(DCA, groups = grp, col = 'tomato', alpha = 0.5) não funciona mais
24.4.2 Fazendo a animação do gráfico
#veg.data <- read.delim ('https://raw.githubusercontent.com/zdealveindy/anadat-r/master/data/vltava-spe.txt', row.names = 1)
#env.data <- read.delim ('https://raw.githubusercontent.com/zdealveindy/anadat-r/master/data/vltava-env.txt')
library(magick)
temp.dir <- tempdir ()
DCA <- decorana(veg = com.data)
#rgl.bg(color = 'white')  # makes the background white não funciona mais
ordirgl(DCA)
movie3d(spin3d(axis = c(0,1,0)), duration=60/5, movie = "ordirgl", fps = 20, dir = temp.dir)
orglspider(DCA, groups = grp)
movie3d(spin3d(axis = c(0,1,0)), duration=60/5, movie = "orglspider", fps = 20, dir = temp.dir)
library(geometry)
source('http://www.davidzeleny.net/anadat-r/doku.php/en:customized_functions:orglhull?do=export_code&codeblock=1')
#orglhull(DCA, groups = grp, col = 'tomato', alpha = 0.5) #não funciona mais
#movie3d(spin3d(axis = c(0,1,0)), duration=60/5, movie = "orglhull", fps = 20, dir = temp.dir)
# Gif files are stored in tempdir:
#temp.dir